
把 Agent 评测放进 CI:从“模型感觉不错”到可阻断的质量门禁
2026 年 9 月 8 日,AWS 发布了用 Amazon Bedrock AgentCore 与 GitHub Actions 自动评测 Agent 的实践。它解决的是 Agent 工程最尴尬的一层:单元测试能检查函数返回值,却无法回答“代理是否以合理路径完成任务”;人工试玩能发现问题,却不能成为每次提交都可重复执行的发布标准。
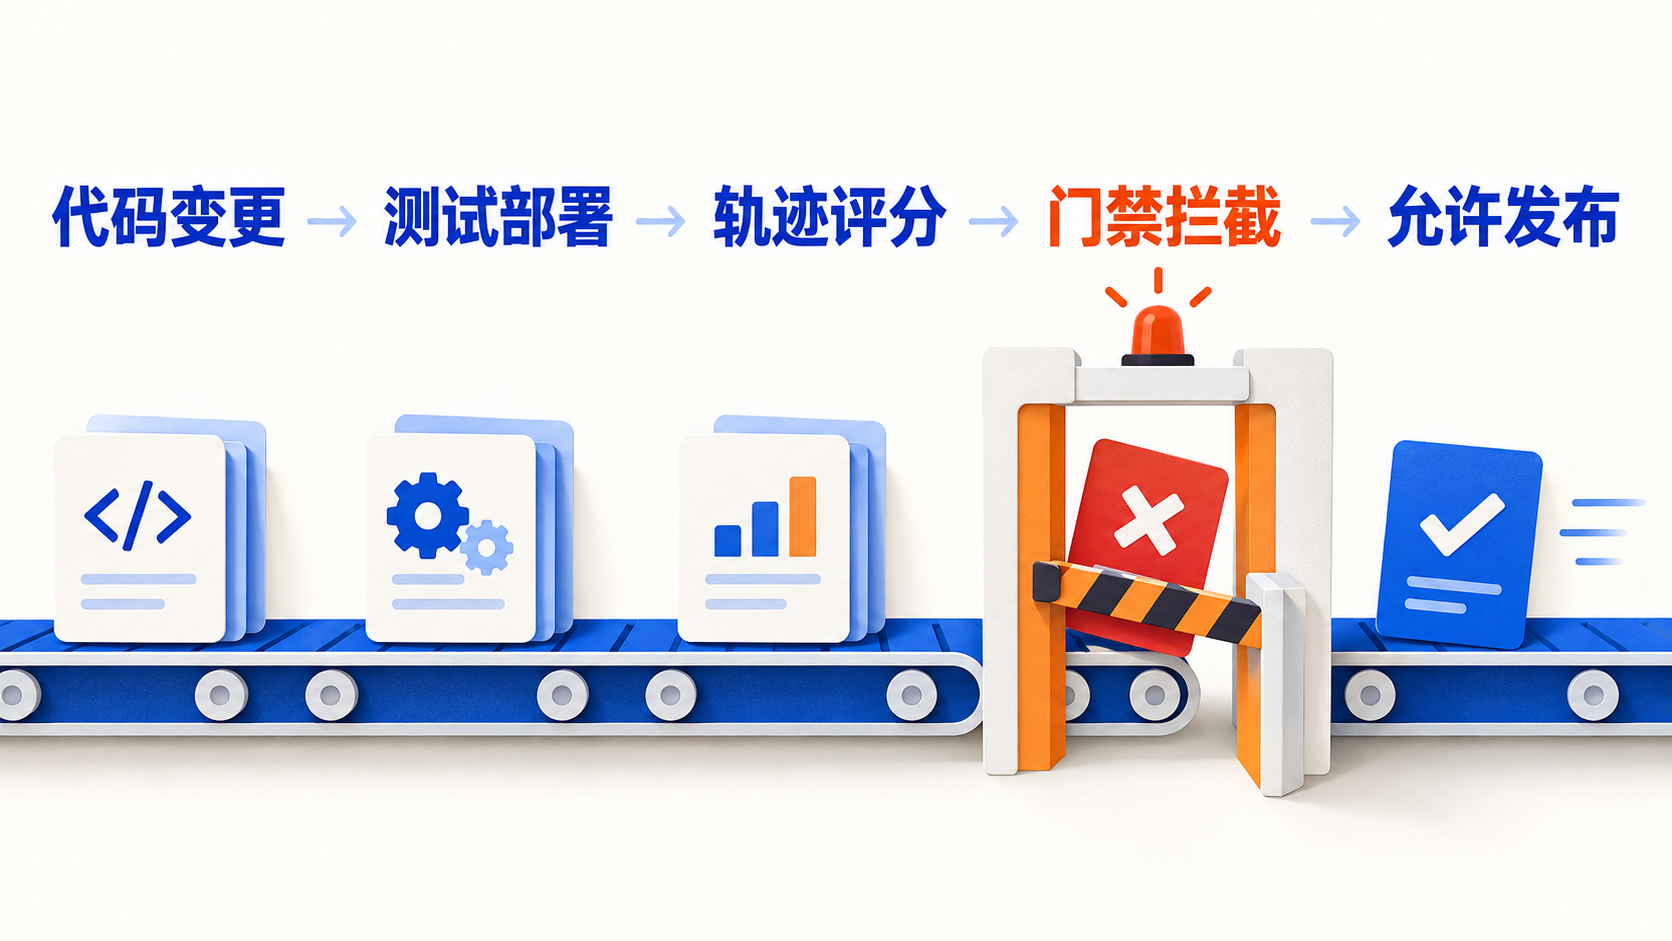
这套方案把测试 Agent、OAuth 保护的 MCP 服务、评测数据集和 AgentCore Evaluate 串进拉取请求。代码提交后,流水线部署隔离版本,用测试身份执行固定任务,采集 OpenTelemetry 轨迹,再由多个评测器给轨迹打分;任一关键指标低于阈值,合并就被阻断。
Agent 的 CI 产物不应只有“成功/失败”,还应包含可回放轨迹、评分证据与回归归因。
评测对象必须从答案扩展到过程
传统测试把最终文本与标准答案比较,但 Agent 的错误往往藏在过程中:多调用了昂贵工具、先读取后越权写入、循环重试、引用了错误的数据版本,或者虽然回答正确却绕开了必要审批。因此至少要把四类信号同时纳入门禁:任务是否完成、工具选择是否正确、路径是否高效、策略是否合规。
轨迹评测比“LLM 打分最终答案”更可诊断。每个 span 应带上运行版本、模型、提示版本、工具版本、输入数据快照、授权主体和成本。分数下降时,团队才能区分模型漂移、提示回归、工具接口变更与测试数据变化。没有这些维度,0.82 降到 0.76 只是一个无法采取行动的数字。
阈值不是一个总分
示例可以用 0.8 作为合并阈值,但生产系统不能只取平均分。安全违规即使只发生一次,也不能被大量简单样本的高分稀释。更实用的门禁是分层的:
| 层级 | 典型指标 | 发布规则 |
|---|---|---|
| 硬约束 | 越权写入、敏感信息外带、跳过审批 | 任一失败即阻断 |
| 任务质量 | 任务成功率、事实一致性、引用覆盖率 | 置信区间下界达标 |
| 运行效率 | 工具调用数、token、延迟、失败重试 | 相对基线不得显著退化 |
| 体验指标 | 表达清晰度、解释充分度 | 可警告,不一定阻断 |
还要避免只在一个固定数据集上“刷榜”。测试集应拆成公开回归集、隐藏挑战集和最近线上失败样本;后两者定期轮换。评测器本身也需要校准:抽样让领域人员双盲复核,计算人与评测器的一致性,并保留争议样本。
CI 身份与生产身份要彻底分离
这套方案同时展示了机器到机器的 client_credentials 与终端用户的 authorization_code。CI 不能借用开发者长期 token,更不能持有生产用户权限。GitHub Actions 应通过 OIDC 换取短期云凭证;MCP 测试客户端只获得测试租户、只读数据和有限工具集合。
流水线还应记录“谁批准了哪组能力”。如果被测 Agent 可以写数据库,测试环境就需要可重置的数据副本、幂等键和出站网络 allowlist。否则一次恶意或异常工具调用,可能让质量验证本身成为事故入口。
企业落地的最小闭环
先选择 20—50 个业务关键任务,不追求一次覆盖所有场景。为每个任务定义成功条件、禁止动作和允许工具,再建立可复现的测试租户。每次提交只跑稳定的冒烟集,夜间跑完整回归;发布后再把真实失败轨迹去标识化,进入候选回归集。
最后,把评测结果与版本发布绑定,而不是只生成一个无人阅读的仪表盘。门禁失败必须自动附上首个分歧 span、与基线相比新增的工具调用、成本变化和可回放链接。Agent CI 的价值不在于证明模型永远正确,而在于让一次退化能够在进入生产之前被观察、解释和阻断。