
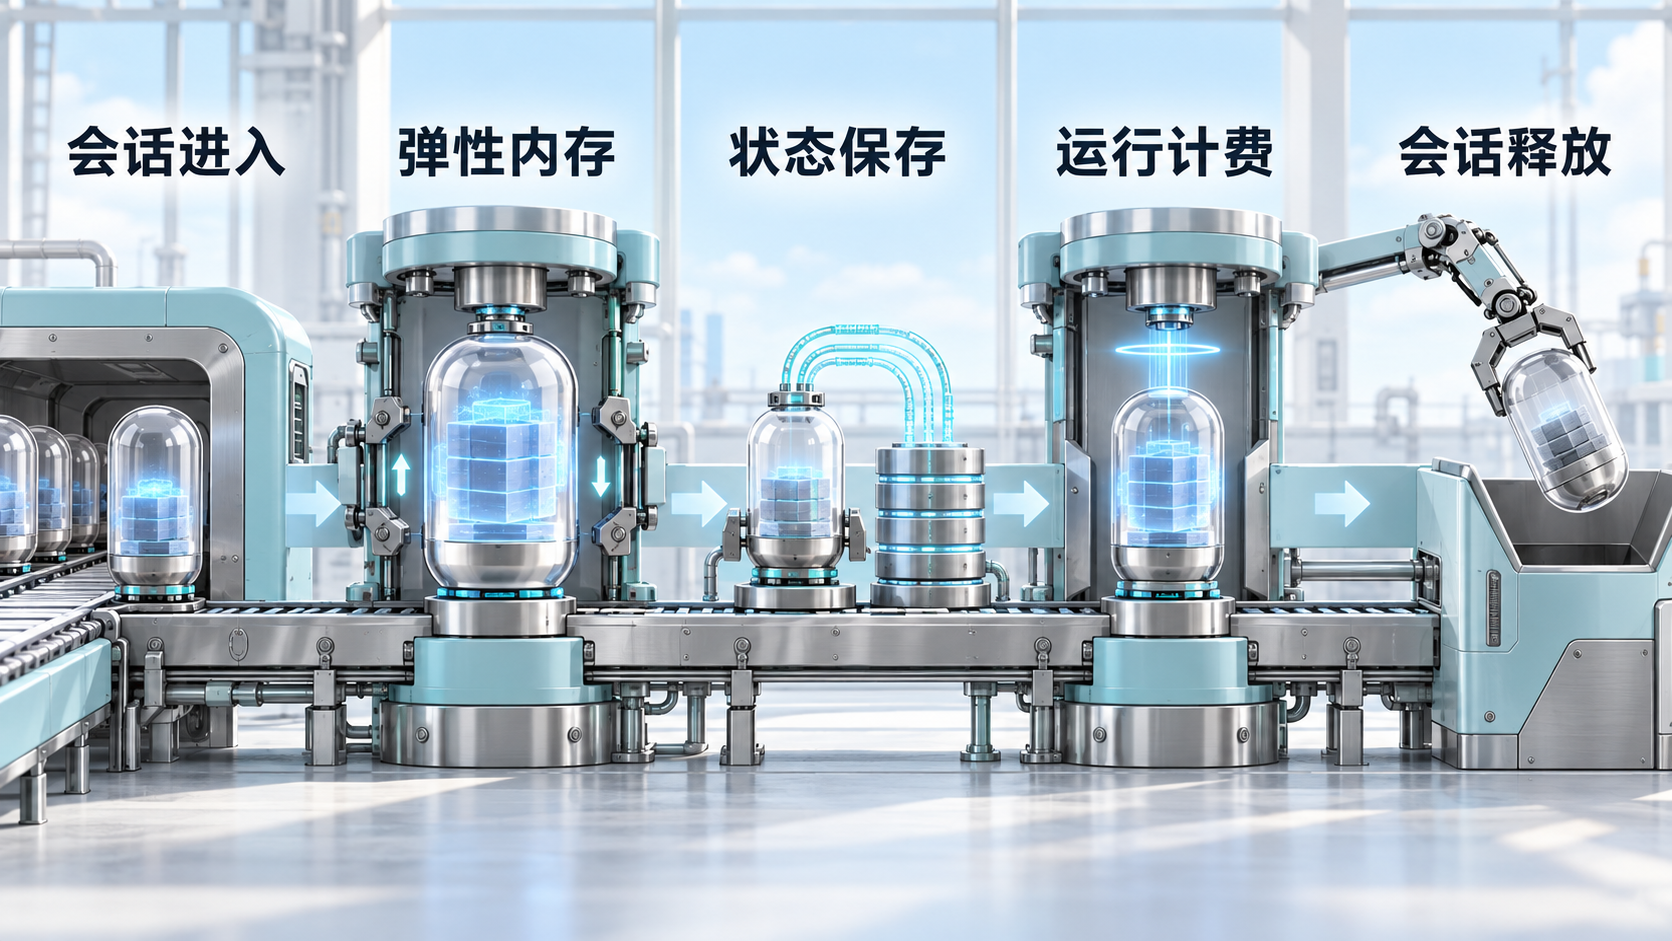
Agent Runtime 的弹性不只看冷启动:会话内存回收决定真实成本
2026 年 9 月 18 日,AWS 介绍新版 AgentCore Runtime:改进会话释放后的内存回收,使冷启动时间不再明显依赖容器大小与并发,并继续支持会话隔离、scale-to-zero 和按实际工作量计费。它对应一个长期被模型吞吐掩盖的问题——Agent 大部分生命周期并不在生成 token,而是在等待工具、外部事件或人。
如果运行时按会话峰值长期占用内存,一个任务读取大文件后即使进入数小时审批等待,资源仍可能被锁住。系统表面上是 serverless,成本行为却像每个会话独占一台常驻服务器。
长任务的状态应持久化,计算资源则应可丢弃;把两者绑在进程内存中,弹性就无从谈起。
将会话状态从工作进程中剥离
Runtime 想要真正 scale-to-zero,进程必须随时可重建。目标、计划、消息摘要、工具结果、文件引用和副作用账本应写入外部持久层;进程内只保留当前推理所需的工作集。等待人类批准时,保存检查点并释放 CPU/内存;事件到达后,用会话 ID 恢复。
需要区分“可重算缓存”和“不可重放状态”。向量检索结果或解析后的文档可以重算;已发送邮件、已创建工单等副作用只能通过幂等账本确认。恢复协议若没有这一区分,内存回收越积极,重复动作风险越高。
冷启动指标必须看尾部
“平均冷启动更快”对 Agent 不够。容器镜像大小、依赖加载、模型客户端初始化、网络策略和状态恢复都会影响 P95/P99。并发放大时,还可能出现镜像拉取风暴与下游连接洪峰。
因此要同时测空状态启动、典型状态恢复、大状态恢复和高并发突发。运行时可以预热基础镜像与连接池,但不能为了消除冷启动而让每个租户常驻。更合理的是预测性保留少量共享容量,同时保持租户状态隔离。
会话隔离不止是容器隔离
容器边界无法自动防止共享缓存串数据、日志泄漏和凭证复用。每个会话需要独立的文件命名空间、网络策略、工具授权与可观测标签。恢复时也要重新验证策略,因为等待期间用户角色、数据权限或工具版本可能已变化。
对 ambient workload,事件可能在没有前台用户的情况下触发。Runtime 应验证事件来源、租户与幂等键,并限制一次唤醒能消耗的预算。否则攻击者只需制造大量低成本事件,就能引发高成本 Agent 执行。
计费应映射到业务阶段
平台账单最好拆成推理、运行时、存储、工具与网络五部分,并按会话阶段归因。若“等待审批”仍持续产生计算费用,说明状态与计算没有真正分离;若恢复费用过高,则需要优化检查点粒度或缓存策略。
企业选型时不要只跑一次 hello world。让 Agent 读取大文档、并行调用工具、暂停一小时、撤销权限后恢复,再制造突发并发。观察内存是否回落、状态是否完整、权限是否重新检查、尾延迟是否稳定。Agent Runtime 的成熟度,最终体现在长时间轴上的资源和状态行为,而不是启动动画有多快。