
跨 ServiceNow、Dynatrace 与 Slack 的 AIOps:根因分析的瓶颈是证据关联
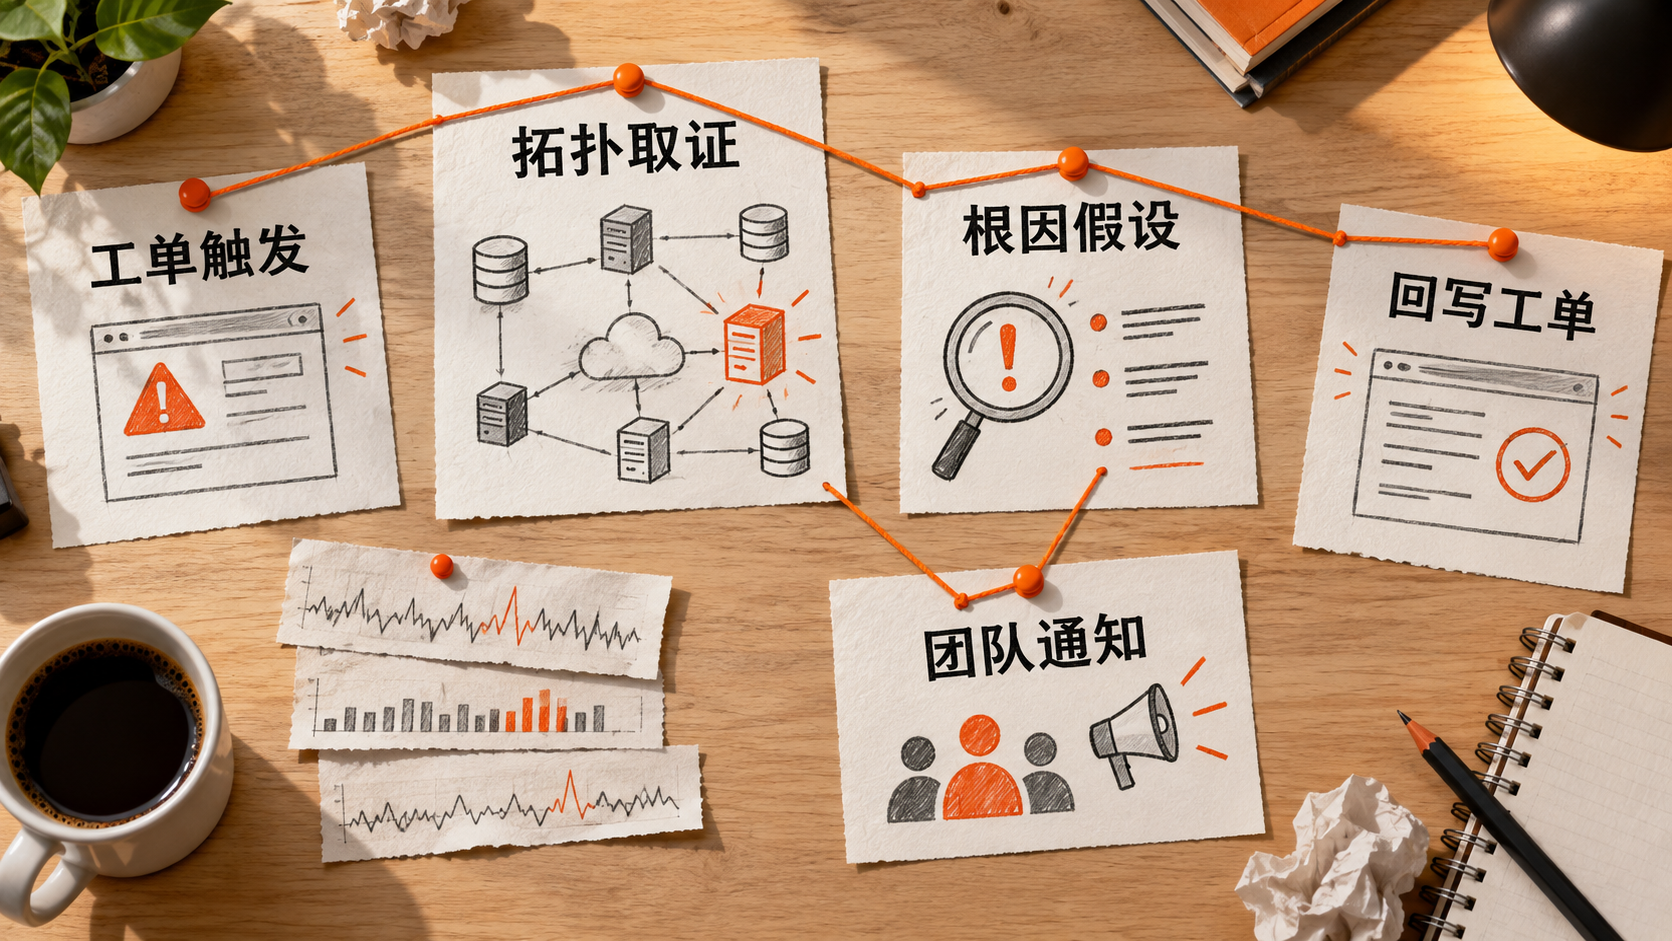
2026 年 9 月 29 日,AWS 展示 AWS DevOps Agent 跨 ServiceNow、Dynatrace 与 Slack 的根因分析流程:ServiceNow 工单触发调查,Agent 从 Dynatrace 读取服务拓扑和遥测,形成假设后回写工单并通知 Slack。方案强调不要求迁移既有工具,还可连接 Datadog、New Relic、Splunk、Grafana、PagerDuty、GitHub、GitLab、Azure DevOps,以及 MCP 和 A2A 工具。
这类 AIOps 的核心价值并非“AI 能看日志”,而是降低证据关联成本。现代事故的信息分散在告警、部署记录、拓扑、工单和群聊中,值班人员最耗时的工作往往是找到同一个变化在不同系统里的身份。
AIOps 应交付带证据的调查包,而不是一句听起来合理的“根因结论”。
先构建调查坐标系
同一应用在 ServiceNow 里可能是 CMDB CI,在 Dynatrace 里是实体 ID,在 Kubernetes 中是 namespace/workload,在 GitHub 中是仓库。Agent Spaces 可以定义账户、集成和访问范围,但平台还需要统一映射表,把服务、环境、团队和版本关联起来。
没有稳定实体关系,模型会依赖名称相似度,极易把 payment-api-staging 与生产服务混淆。拓扑还要带时间:事故发生时的依赖关系可能与当前不同。调查必须查询事件窗口内的版本与拓扑快照。
根因假设需要证据链和反证
一次可靠调查至少包含症状、时间线、变化点、候选假设、支持证据、反证和置信度。例如“数据库连接池耗尽”不能只由一条错误日志得出,还应看到连接等待上升、应用版本变化、数据库本身健康,以及扩容或回滚后的恢复关系。
Agent 应记录每条证据来自哪个工具、使用了什么查询、覆盖哪个时间区间。无法访问的数据源必须列为缺口。AIOps 最危险的失败不是“没有找到根因”,而是把相关性包装成确定因果,导致团队执行错误修复。
读与写要采用不同授权模型
跨工具调查需要广泛读取,但回写工单、发送通知和执行修复的风险不同。读取遥测可以按服务范围授权;写工单限制模板和字段;群聊通知先草拟后发送;回滚、扩容或封禁流量则进入独立审批。
Agent 不应直接使用值班人员的永久凭证。每个连接器通过短期身份访问,所有查询和动作带统一 incident ID。敏感日志在送入模型前进行脱敏,并限制跨区域传输。
评价 AIOps 要看 MTTR 的分解
只看平均恢复时间会掩盖事故难度差异。更实用的指标包括首次可行动假设时间、证据收集耗时、误导性假设率、人工查询次数、自动回写准确率和修复后复发率。对没有自动修复的系统,减少“找数据”的时间本身就能创造明显价值。
上线前用过去事故做盲测:只提供当时可用的数据,让 Agent 与人工调查时间线比较;不能把事后复盘结论直接放进上下文。生产初期保持只读建议模式,并让值班人员标记有用证据与错误关联。跨工具 AIOps 的成熟标志,不是接入的图标数量,而是它能否在权限边界内把分散事实拼成可追溯、可反驳、可交接的调查过程。