
OpenAI Agents API:托管的不是一次调用,而是可恢复的 Agent Harness
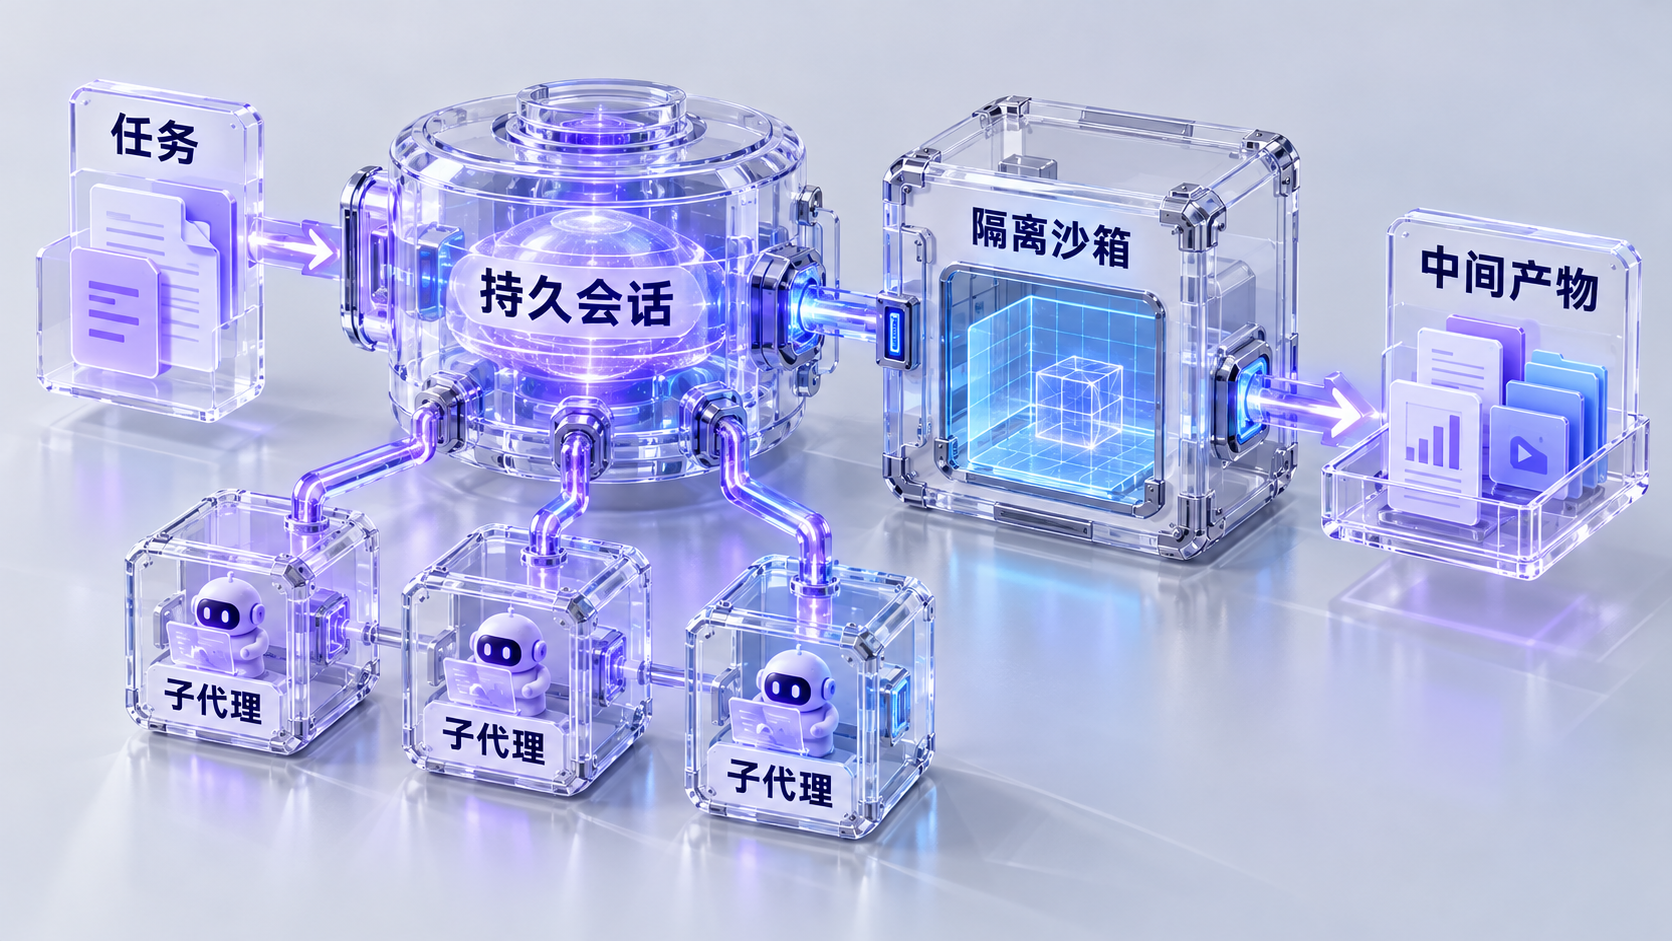
OpenAI 在 2026 年 9 月 10 日发布 Agents API 公测。它不是给 Responses API 再包一层循环,而是把 Codex 使用的 harness 作为托管能力开放:任务可运行数小时甚至数天,拥有持久会话、自动上下文压缩、故障恢复、子代理、工具与 MCP 接入,并能在托管沙箱、企业自有基础设施或合作方沙箱中执行。
这说明 Agent Runtime 的竞争单位已经变化。企业不再只比较模型每秒输出多少 token,而要比较一个长任务能否中断、恢复、审计和交付产物。一次模型响应是瞬时函数;一个 Agent 运行则更接近有状态工作流。
真正需要持久化的不是完整聊天文本,而是目标、计划、工具副作用、检查点与产物引用。
Durable Session 不等于保存聊天记录
如果恢复任务时只把历史消息重新塞进上下文,系统会重复调用工具、重新写文件,甚至再次付款。可恢复执行需要把状态拆开:对话上下文用于推理,任务状态用于调度,外部副作用进入账本,文件和报告进入对象存储,凭证则由运行时按需换取。
每个工具调用至少应带 run_id、step_id 和幂等键。恢复时运行时先查询副作用账本:已成功的步骤读取结果,不确定的步骤进入补偿或人工确认,而不是盲目重放。上下文压缩也必须保留未完成承诺、关键证据来源和权限边界;仅让模型自由总结,很容易把“不允许发送邮件”压缩掉。
子代理是资源调度,不只是角色扮演
官方示例允许设置并发子代理数。并发能把调研、代码检查和数据分析并行化,但会引入共享状态冲突、重复检索和成本放大。一个可靠的父代理应给每个子代理声明输入、输出 schema、预算、可用工具和截止条件,并只通过产物引用合并结果。
并发上限必须是平台能力而不是 prompt 建议。假设每个子代理又能启动三个子代理,两层展开就可能产生指数级任务。平台要同时限制树深、总运行数、token、工具调用与外部费用,并在预算耗尽时返回“部分完成 + 缺口”,而不是生成貌似完整的答案。
三种执行位置对应三种信任边界
托管沙箱适合快速获得隔离和弹性,但企业需要确认数据驻留、网络出口、镜像来源和产物保留策略。自有基础设施便于接入内网和现有审计系统,却把补丁、资源隔离与弹性扩缩交还给团队。合作方沙箱则增加一层供应链和身份传播问题。
选择不能只看“代码在哪里跑”,还要画出模型、运行时、工具、数据和人分别属于哪个控制域。高风险工具可以在企业网关后执行,只向托管会话暴露最小 schema;站点登录由应用处理,Agent 只获得短期、限定范围的授权结果。
生产验收看五个故障场景
第一,运行中模型接口超时,是否从最近检查点恢复。第二,工具返回成功但网络响应丢失,是否避免重复副作用。第三,压缩发生后,权限约束是否仍在。第四,子代理部分失败时,父代理能否标记不确定性。第五,任务暂停数小时后,旧凭证是否失效并重新授权。
Agents API 降低了构建 harness 的成本,却没有消除企业对可靠性和治理的责任。平台团队真正要保留的是独立的运行账本、策略网关、评测与可迁移的工具协议。把所有状态只交给一家托管 API,短期轻松,长期却很难证明一次任务为何做出了某个动作。