
用生产轨迹优化 Agent Prompt:从自动改写到可证伪的发布实验
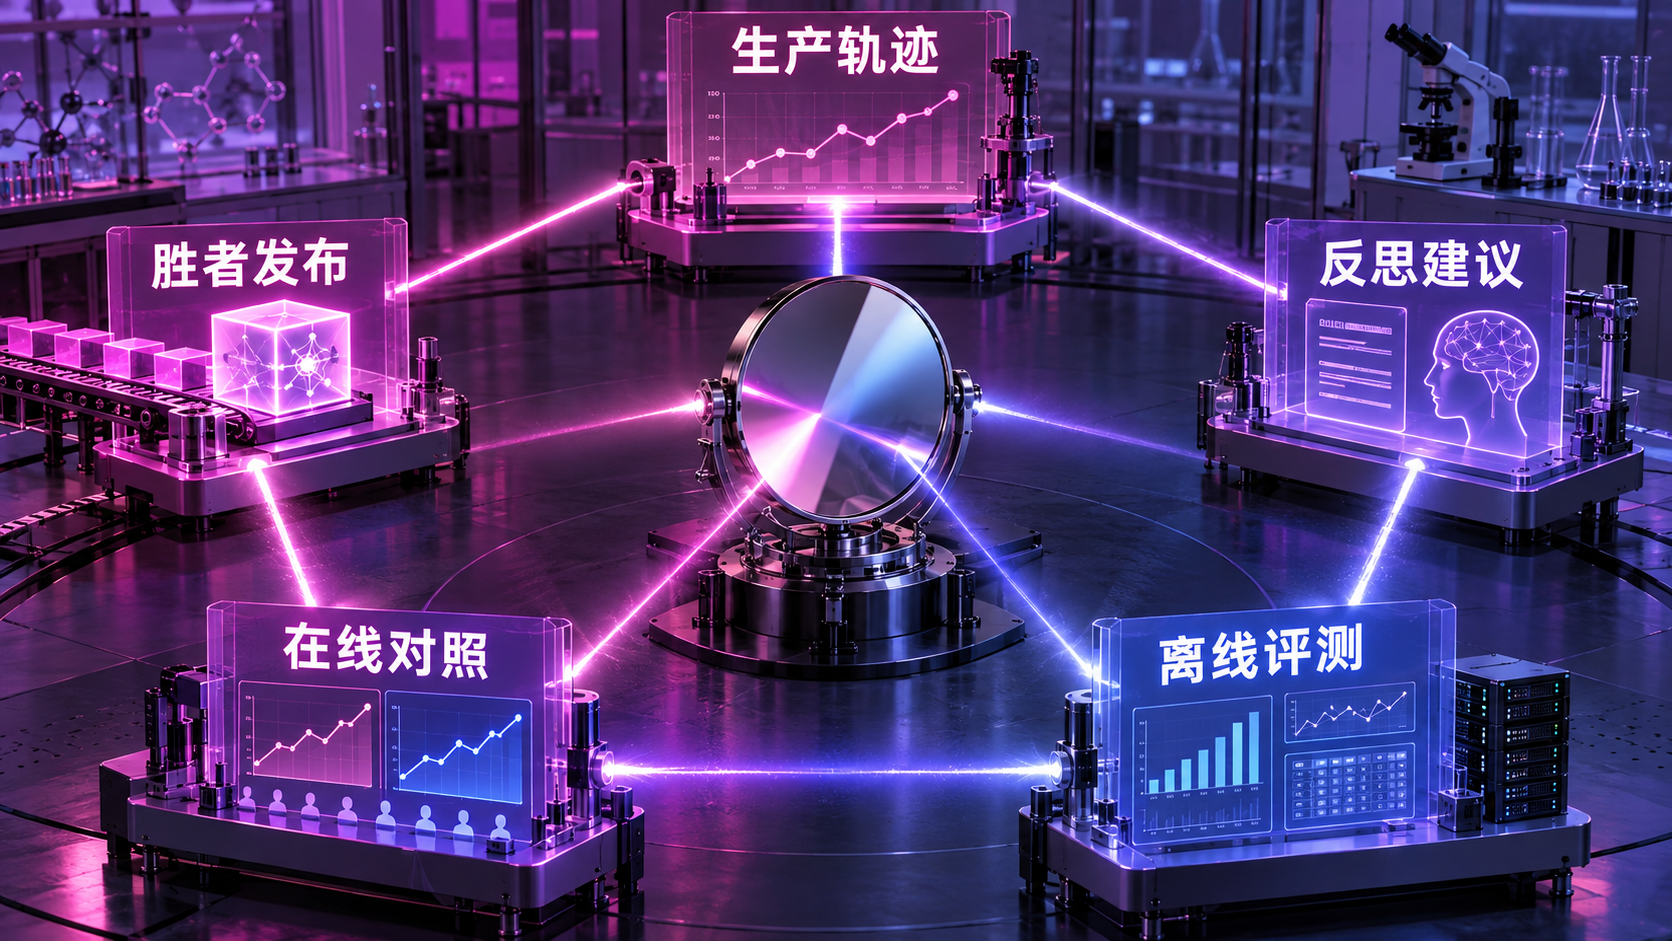
2026 年 9 月 16 日,AWS 发布基于 Amazon Bedrock AgentCore 生产轨迹优化系统提示的方案:Observability 收集真实运行,评测器产生奖励信号,推荐模块给出提示修改及解释,再通过离线批测和在线 A/B 实验决定是否发布。官方还指出,同样方法可扩展到工具描述与 skills。
这条链路将 prompt 从“工程师凭经验编辑的文本”变成可观测、可实验的运行配置。但如果把低分轨迹直接交给模型改写,再自动上线,就会形成一个危险的自反馈系统:评测器偏好会被不断放大,线上分布的偶然噪声会固化成规则,少数高风险场景则可能被平均收益掩盖。
优化系统应提出可证伪假设,而不是直接把“新 prompt”当成答案。
先把轨迹变成可比较样本
生产轨迹天然带偏差:成功用户更愿意继续交互,失败用户可能直接离开;不同版本面对的任务难度也不同。进入优化器前,需要按任务类型、风险等级、客户分群和工具版本分层采样,并移除敏感数据。每条样本要冻结输入、可用工具和外部数据快照,否则无法重放。
奖励不能只有一个满意度总分。任务成功、事实正确、工具路径、安全约束、成本与延迟应分别记录,并标记硬约束。若新提示把平均调用数降了 20%,却增加一次越权调用,它就不应获胜。
修改必须可解释且最小化
推荐模块应输出“观察—假设—修改—预期影响”,例如:退款任务中模型在确认订单前调用支付工具;假设是步骤优先级不明确;修改是在系统提示中增加先验证后执行的约束;预期降低无效写调用。这样审阅者可以判断因果是否合理。
一次只改少量规则更容易归因。大段重写会同时改变语气、规划、工具选择与安全边界,即使指标上升,也无法知道是哪一项产生作用。Prompt 版本应像代码一样保留 diff、审批人与关联实验。
离线评测与在线实验承担不同责任
离线阶段适合阻断已知回归:历史失败、红队样本、边界条件和固定基准全部重放。它无法覆盖真实用户分布,也无法完全模拟第三方工具状态。因此通过离线门禁后,只能以小流量进入在线实验,并设置安全熔断。
在线实验不能只比较会话点赞。应同时观察任务完成时间、人工接管率、工具错误、撤销动作、token 与外部 API 费用。对于低频高损失事件,用统计显著性等待很久并不合理,应设零容忍规则或采用影子执行。
防止优化器“讨好评测器”
如果同一个模型既改 prompt 又评分,最容易学会评测器喜欢的表达,而非提高真实能力。可通过多评测器、规则检查、人类抽审与隐藏集降低风险;定期更换挑战集,并监控离线得分与业务结果的相关性。当两者开始背离,应暂停自动推荐。
成熟的闭环还需要冠军/挑战者、自动回滚和冷却期。新版本先小流量运行,硬指标触发立即回滚;即使获胜,也要等待一段时间再开始下一轮,避免频繁变化导致轨迹不可比较。自动 Prompt 优化真正的边界不是“模型能否写得更好”,而是组织能否证明每次变化为何发生、改善了什么、没有破坏什么。